
JumboGemiste omzet
Freelance data & digital specialist
Data. Technologie. Digitale oplossingen.
Ik ontwerp en bouw datagedreven oplossingen, slimme integraties en digitale toepassingen die bedrijven vooruithelpen.
Ik combineer data, technische kennis en een pragmatische aanpak om oplossingen te bouwen die organisaties vooruithelpen.
Data omzetten in bruikbare inzichten die organisaties helpen betere beslissingen te nemen. Van data-analyse en KPI-ontwikkeling tot interactieve dashboards en rapportages die complexe informatie begrijpelijk maken.
Betrouwbare datastructuren ontwerpen en verschillende databronnen verbinden tot één samenhangend geheel. Van het integreren van API’s en databases tot het modelleren en transformeren van data: een solide basis voor analytics en rapportages.
Data science en AI inzetten om patronen te ontdekken, processen slimmer te maken en nieuwe mogelijkheden te verkennen. Van statistische analyses en voorspellende modellen tot praktische AI-toepassingen die waarde toevoegen aan bestaande processen.
Ideeën en zakelijke uitdagingen omzetten in werkende digitale oplossingen. Van websites en webapplicaties tot interne tools en prototypes: technologie en pragmatisch probleemoplossen gecombineerd om ideeën werkelijkheid te maken.
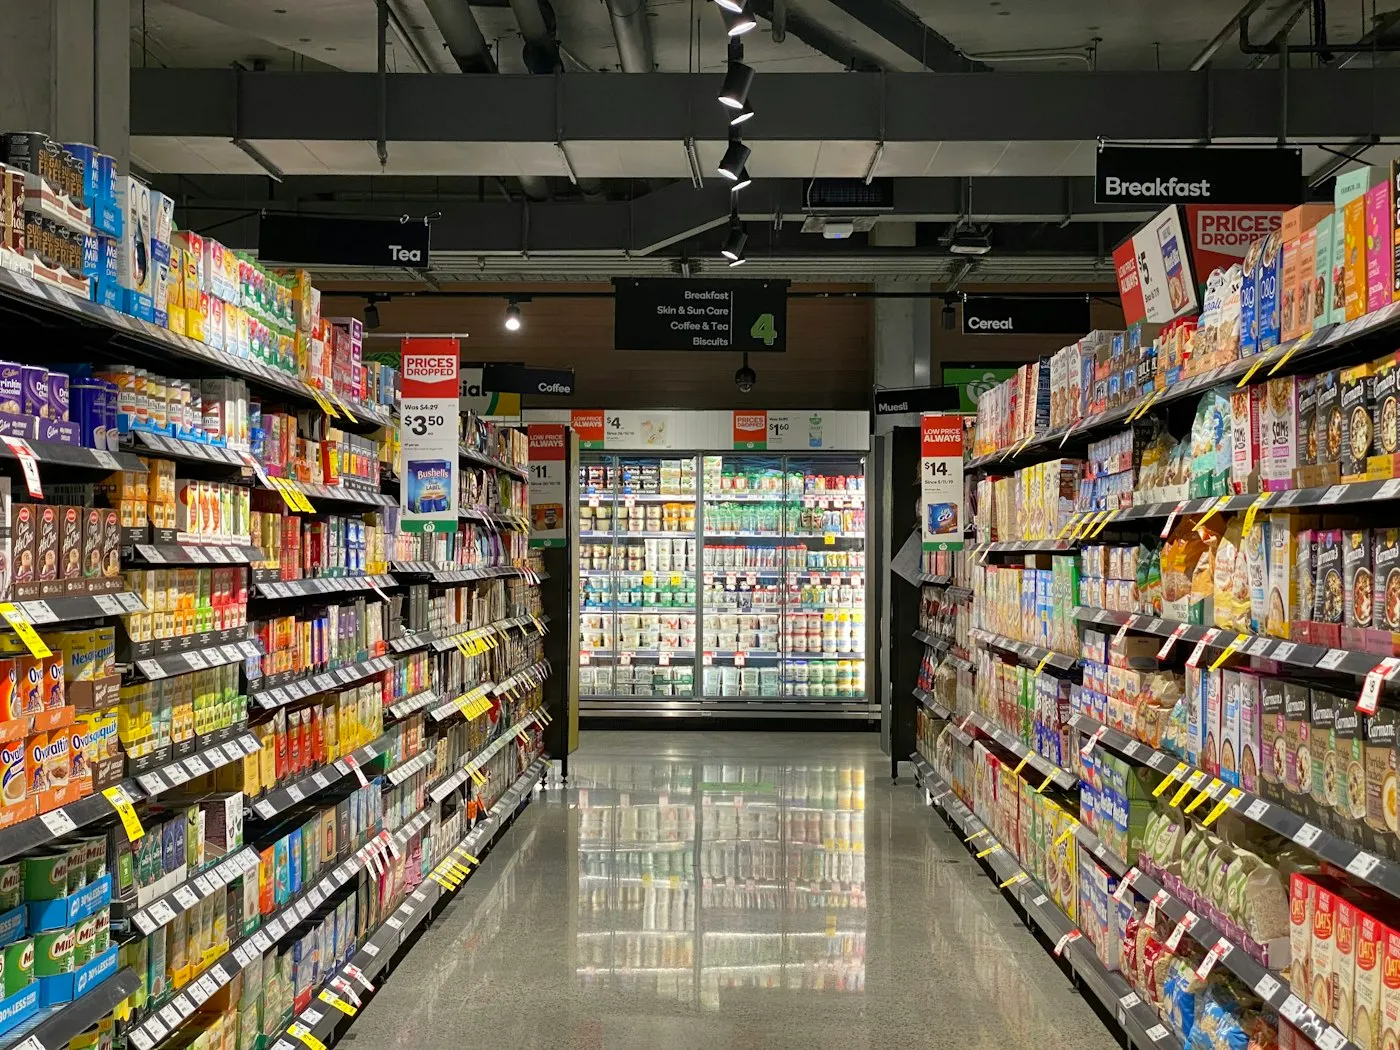
Ligt een product niet in het schap, dan loopt een supermarkt omzet mis. Voor Jumbo hebben we berekend hoeveel dat is, voor alle producten in alle winkels in Nederland.
De berekening kijkt naar drie factoren: hoeveel uur een product niet in het schap ligt, hoe belangrijk het product is voor de klant en of die een vervanger kiest of de productsoort helemaal niet koopt. Een product dat klanten echt missen, weegt daardoor zwaarder dan een product dat ze makkelijk vervangen.
De combinatie van alle producten en winkels leverde een zeer grote dataset op. Daarom hebben we de berekening geoptimaliseerd, zodat die op deze schaal goed draait.
Illustratie met voorbeelddata, geen echte cijfers.
Hoeveel extra verkoopt een product als het in de aanbieding staat? Voor Jumbo hebben we die uplift inzichtelijk gemaakt: het verschil tussen de verkoop tijdens een promotie en de normale verkoop.
De basis was een dataset van het data science team met voorspellingen van de verkoop per product. Die inzichten bestonden per week, maar Jumbo wilde ze per dag kunnen zien.
Daardoor werd de dataset ongeveer zeven keer zo groot, tot miljarden regels. We hebben de verwerking daarom geoptimaliseerd. De inzichten zijn belangrijk voor inkoop en voorraadplanners.
Illustratie met voorbeelddata, geen echte cijfers.
Tijdens de coronacrisis had de GGD snel inzicht nodig in wat er speelde. Daarom hebben we dashboards ontwikkeld over de testlocaties, de testresultaten en de vaccinatiegraad in Nederland.
Per testlocatie was zichtbaar hoe die presteerde, bijvoorbeeld op doorlooptijd. Zo was direct duidelijk welke locaties goed draaiden en waar moest worden ingegrepen. Ook het aantal positieve tests was een belangrijke graadmeter: liep dat op, dan ging het de verkeerde kant op.
De vaccinatiegraad in Nederland moest omhoog. Daarom hebben we die per postcode op een kaart van Nederland gezet, zodat direct zichtbaar was waar de graad laag was. Naar die gebieden reden bussen waar mensen zonder afspraak een vaccinatie konden halen.
Illustratie met voorbeelddata, geen echte cijfers.
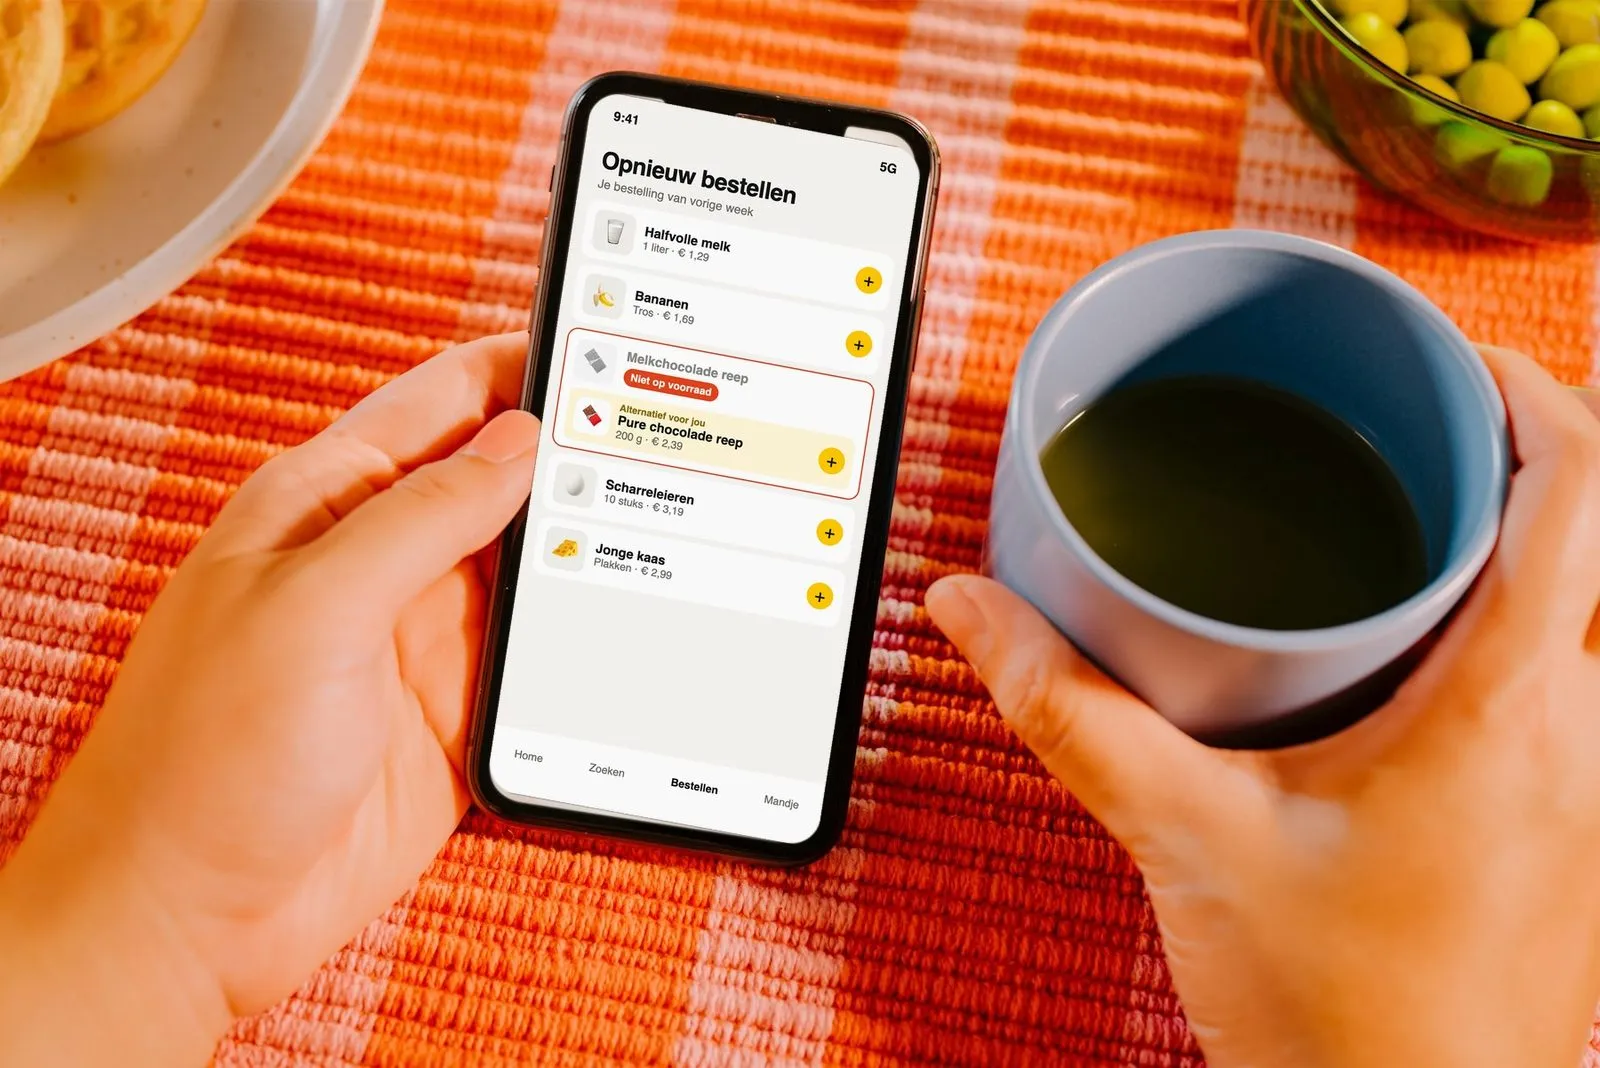
Bij Jumbo kunnen klanten online bestellen en op basis van eerdere bestellingen snel opnieuw boodschappen doen. Soms is een product echter niet meer beschikbaar. Dat is vervelend voor de klant en kost omzet. Daarom biedt de webpagina dan alternatieven aan.
Jumbo wilde weten of dat werkt. Daarom hebben we met data inzichtelijk gemaakt of de alternatieven worden gezien, of klanten erop klikken en of dat tot conversie leidt.
Met die inzichten kan Jumbo de alternatieven zichtbaarder maken of de keuze ervan verbeteren, zodat een product dat niet beschikbaar is alsnog tot een verkoop leidt.
Illustratie met voorbeelddata, geen echte cijfers.
Het hele jaar door haalt Jumbo producten uit de schappen. De kosten van zo’n sanering waren alleen grof ingeschat. Daarom hebben we een analyse ontwikkeld die deze kosten per product veel specifieker berekent.
De kosten hangen sterk af van de omvang van de sanering. Verdwijnt een product uit een deel van de winkels, dan speelt de voorraad in het distributiecentrum geen rol. Verdwijnt het uit alle winkels, dan blijft die voorraad over en moet die worden vernietigd of met korting verkocht. Ook dat hebben we in de berekening meegenomen.
De analyse kijkt precies hoeveel voorraad er nog is en hoeveel restanten er in de winkels liggen. Met een script is de kostenbenadering snel te berekenen, zodat die kan meewegen in de beslissing om een product te saneren.
Illustratie met voorbeelddata, geen echte cijfers.
Een winkel wil zo min mogelijk restanten. Om daarop te kunnen sturen, hebben we voor Jumbo een curated tabel ontwikkeld die in de hele organisatie gebruikt kan worden.
Eerst hebben we een definitie opgesteld van wat een dagrestant is, zodat iedereen die de tabel gebruikt met hetzelfde cijfer werkt.
Ook dit was een zeer grote dataset. We hebben daarom bepaald welke data wel en niet in de tabel moest en deze daarop geoptimaliseerd.
Met deze inzichten ziet Jumbo welke winkels en producten te veel restanten hebben, en kan het die gericht verminderen.
Illustratie met voorbeelddata, geen echte cijfers.
Kinderen in asielzoekerscentra ondergaan na aankomst in Nederland medische activiteiten. Die verschillen per leeftijdsgroep: kinderen van 0 tot 4 jaar hebben een andere intake dan kinderen van 5 tot 18 jaar. De betalingen daarvoor verliepen via handwerk en Excel-bestanden.
Die betalingen konden complex worden. Een kind kon meerdere behandelingen of tests krijgen, soms in verschillende regio’s, waardoor een betaling moest worden gesplitst. Daarom hebben we veel aandacht besteed aan duidelijke businessdefinities.
De data klopte in eerste instantie niet. Samen met de data engineers hebben we eerst de bron op orde gebracht, in plaats van de data in een latere fase te repareren: garbage in is garbage out.
Het resultaat is een dashboard en een pdf die wekelijks en maandelijks voor de betalingen worden gegenereerd.
Illustratie met voorbeelddata, geen echte cijfers.
Bij GVB lag al een deel van het datafundament, maar er werd nog weinig mee gedaan. Iedereen werkte met eigen Excel-bestanden en had een eigen waarheid. Daarom hebben we één dashboard ontwikkeld voor de hele organisatie, met één uniforme waarheid.
Het dashboard toont de basiscijfers die iedereen wil kunnen inzien: de ritten die reizigers maken per bus, tram of metro, welke lijnen druk bezet zijn en op welke tijden.
In een later stadium kwam de productverkoop erbij. Van sommige abonnementen ontbrak data en losse verkopen waren niet goed geregistreerd. Samen met het data engineering team hebben we bepaald hoe we dit wilden modelleren en wat de organisatie wilde zien, zodat ook hiervoor dashboards konden worden gebouwd.
Zo werkt iedereen binnen GVB met dezelfde cijfers en gaat de aandacht naar beslissingen in plaats van naar de vraag welk cijfer klopt.
Illustratie met voorbeelddata, geen echte cijfers.
Athlon ontving leads van mensen met interesse in leaseauto’s en adverteerde online, maar wist niet waar die leads vandaan kwamen. De twee systemen konden niet met elkaar praten. Daarom hebben we de herkomst van leads inzichtelijk gemaakt.
Google Analytics is een mooi platform voor eerste inzichten, maar de data is sterk geaggregeerd en de ruwe data is er niet zichtbaar. Daarom hebben we de data overgezet naar BigQuery. Daaruit konden we veel meer informatie halen en de koppeling met het systeem van Athlon maken.
Vervolgens is de data van BigQuery naar Snowflake gegaan, het platform waarmee Athlon werkt. Vanuit daar zijn de inzichten en dashboards in Qlik gemaakt. Zo ziet Athlon welke kanalen leads opleveren.
Illustratie met voorbeelddata, geen echte cijfers.
Het salesteam van Athlon benaderde nieuwe leads zonder vaste volgorde. Interessanter is om eerst de leads met de meeste waarde te benaderen. Daarom hebben we een scoringsmodel opgezet dat leads prioriteert.
Daarvoor was meer data over de leads nodig. Via de API’s van een partij die data over bedrijven verzamelt, hebben we die data opgehaald en op KvK-nummer gekoppeld aan onze leads. Zo kregen we inzicht in onder meer de sector en het wagenpark van een bedrijf.
Daarnaast gebruikten we interne data over budgetten en de gemiddelde bestedingen per sector om te voorspellen hoeveel een bedrijf nog kan besteden. Zo kan het salesteam de potentieel meest winstgevende leads als eerste benaderen.
Illustratie met voorbeelddata, geen echte cijfers.
GVB ontvangt veel klachten. Elke maand werden die in Excel doorgelezen om een globaal beeld te krijgen. Die werkwijze is arbeidsintensief en gevoelig voor menselijke fouten. Daarom hebben we een model ontwikkeld dat laat zien waar de klachten over gaan.
Na het testen van meerdere modellen kwamen we uit op BERTopic. Dat model groepeert teksten die over hetzelfde gaan, ook als mensen andere woorden gebruiken, en haalt er automatisch de onderwerpen uit.
Een belangrijk deel van het werk zat in de voorbereiding van de data. In het klachtenveld kunnen mensen alles invullen, dus er stond ook onbruikbare tekst en soms gevoelige informatie in. Die moest eruit worden gefilterd.
De resultaten staan in een dashboard. Zo heeft GVB elke maand een goed overzicht en bespaart het veel tijd.
Illustratie met voorbeelddata, geen echte cijfers.
GVB had al data over reizigers, maar wilde meer weten over de groepen die het bedient. Tot dan toe waren die groepen vastgesteld met kwalitatief onderzoek, via interviews. Wij wilden dat kwantitatief doen, op basis van data.
Daarvoor hebben we een segmentatiemodel met k-means clustering gebruikt. Dat deelt reizigers in groepen in die zoveel mogelijk op elkaar lijken. Zo kwamen we op een aantal groepen met elk eigen kenmerken.
Daaruit bleek onder meer dat een kleine groep voor een groot deel van de omzet zorgt. Omdat elke groep zich anders gedraagt, kan GVB ze ook anders benaderen, bijvoorbeeld met gerichte marketing of acties.
Illustratie met voorbeelddata, geen echte cijfers.
GVB wilde dat zoveel mogelijk mensen het Flex-abonnement gebruikten. Elke maand kwamen er klanten bij, maar er gingen ook klanten weg. Het doel was om die klanten te behouden.
Op basis van de beschikbare klantdata hebben we een churnmodel ontwikkeld dat voorspelt welke klanten de grootste kans hebben om op te zeggen. Die klanten kunnen dan gericht worden benaderd om ze te behouden.
We begonnen met een logistische regressie en vergeleken die met geavanceerdere modellen. De logistische regressie gaf de beste uitkomsten en is daarom gebruikt. Een bijkomend voordeel is dat dit model goed uitlegbaar is.
Illustratie met voorbeelddata, geen echte cijfers.
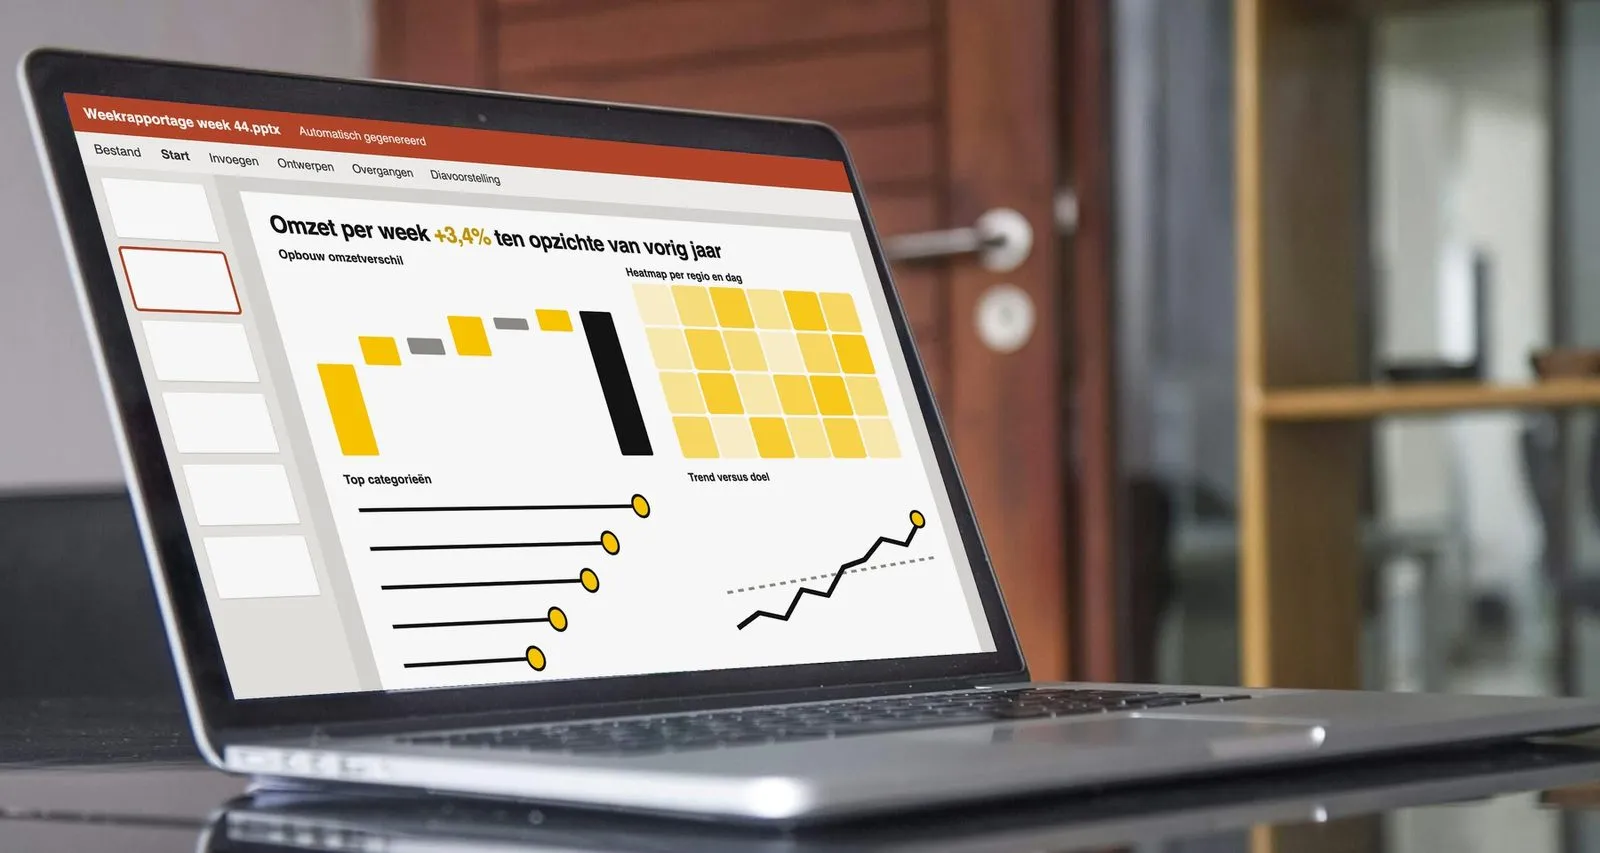
Niet iedereen wil met een dashboard werken. Bij Jumbo wilden stakeholders grafieken in een PowerPoint, zonder die elke week zelf te hoeven maken met screenshots van dashboards. Daarom hebben we een script ontwikkeld dat deze PowerPoint wekelijks genereert.
De wensen voor de grafieken waren erg gevarieerd en gingen verder dan de standaardfunctionaliteit van PowerPoint. Daarom hebben we de grafieken in Python met matplotlib gemaakt, precies zoals de klant ze wilde.
Het script draait in Databricks en via een koppeling met SharePoint vinden stakeholders elke week de juiste PowerPoint. In dit project komen veel grafieken, dashboards en data samen.
Illustratie met voorbeelddata, geen echte cijfers.
Als consultancypartij moet Data Science Lab opdrachten binnenhalen. Een externe partij verzorgde de cold mailing, maar de resultaten stelden niet altijd tevreden en de e-mails waren statisch. Daarom hebben we dit zelf ontwikkeld, voor meer volume en betere kwaliteit.
Via een platform en API’s verzamelden we klantgegevens en e-mailadressen. Door bedrijfswebsites te scrapen konden we elk bedrijf categoriseren per industrie. Een LLM schreef vervolgens een persoonlijke opener voor de eerste e-mail.
Zonder reactie volgden nog een tweede en derde e-mail. Reageerde iemand wel, dan stopte de reeks. Een LLM beoordeelde het sentiment van die reacties: is er interesse of niet?
Om snel te kunnen starten is alles gebouwd op het low-code platform Make.com, meteen een goede test van zulke platformen. De aanpak leverde behoorlijk wat reacties op en na enige tijd de eerste klant.
Illustratie met voorbeelddata, geen echte cijfers.
Bij VolkerWessels kon data veranderen zonder dat daar zicht op was. Het onderwerp van de data maakte voor dit project niet uit: het ging erom dat in korte tijd zichtbaar werd dat de data was gewijzigd.
Daarvoor was een snapshotmechanisme nodig: je legt vast hoe de data er op een moment uitziet en vergelijkt dat met de volgende versie. Zo is precies te zien wat er anders is.
De uitkomst staat in een Tableau-dashboard. Een heatmap signaleert snel in welke cellen de data is gewijzigd, zodat niemand alles handmatig hoeft na te lopen.
Illustratie met voorbeelddata, geen echte cijfers.
Ik ontdek mogelijkheden, verbind ideeën en bouw praktische oplossingen met data en technologie.
Ik ben Marco, een zelfstandige professional met een brede interesse in data, technologie en digitale innovatie.
Na mijn studie aan de Rijksuniversiteit Groningen heb ik bij verschillende organisaties gewerkt aan uiteenlopende vraagstukken op het gebied van data en technologie. Daarbij heb ik ervaring opgedaan met onder andere business intelligence, data-analyse, datamodellering en het ontwikkelen van technische oplossingen. Door bij verschillende organisaties en in verschillende omgevingen te werken, heb ik geleerd om snel nieuwe vraagstukken te doorgronden en me nieuwe technologieën eigen te maken.
Wat mij vooral aanspreekt, is het combineren van analytisch denken en praktisch bouwen. Ik vind het interessant om complexe problemen uit te pluizen, verbanden te ontdekken en mogelijkheden te onderzoeken. Daarbij staat voor mij niet de technische complexiteit centraal, maar het resultaat. Ik kijk naar wat er mogelijk is, welke aanpak het beste past en hoe je met de beschikbare middelen tot een zo goed mogelijke oplossing komt.
Ik werk graag zelfstandig en neem het liefst verantwoordelijkheid voor het volledige traject: van het begrijpen van een vraagstuk en bepalen van de juiste aanpak tot het ontwikkelen en realiseren van de oplossing. Juist die afwisseling tussen denken, uitzoeken en bouwen maakt mijn werk interessant.
Klik op een klant om de projecten te zien.
Heb je een vraag of een project in gedachten? Stuur me een bericht, dan neem ik zo snel mogelijk contact met je op.
Bekijk mijn profiel op LinkedInBedankt voor je bericht!
Ik neem zo snel mogelijk contact met je op.